先講結論:
- LLM(Large Language Model,大型語言模型) 是一種用大量文字訓練出來的 AI 模型,能寫文字、回答問題、整理重點、翻譯。
- 它的核心動作很單純:看前面的文字,猜接下來最可能出現的一段字,一段接一段,就成了完整的回答。
- ChatGPT、Claude、Gemini 是產品;LLM 是產品背後的引擎。產品還會加上對話介面、上傳檔案、搜尋、記憶等功能。
- 限制要先知道:知識有截止日、會一本正經地講錯、一次能讀的內容有上限。
先分清楚:這篇講的是 AI 的 LLM
搜尋「LLM 是什麼」,常會看到兩種完全不同的東西:
| 你看到的 | 意思 |
|---|---|
| AI 的 LLM(本篇) | Large Language Model,大型語言模型 |
| 法律的 LL.M. | Master of Laws,法學碩士學位 |
兩者只是縮寫剛好一樣,跟 AI 無關。
LLM 怎麼回答問題?一直猜「下一段字」
Google 的機器學習課程這樣定義語言模型:它估計某一段文字(Token)出現在一串文字裡的機率。LLM 做的事,就是根據你前面給的內容,預測接下來最可能出現的 Token,一次可以接著預測成千上萬個 Token。Google 也直接說,LLM 本質上就像一個「自動完成」機制。
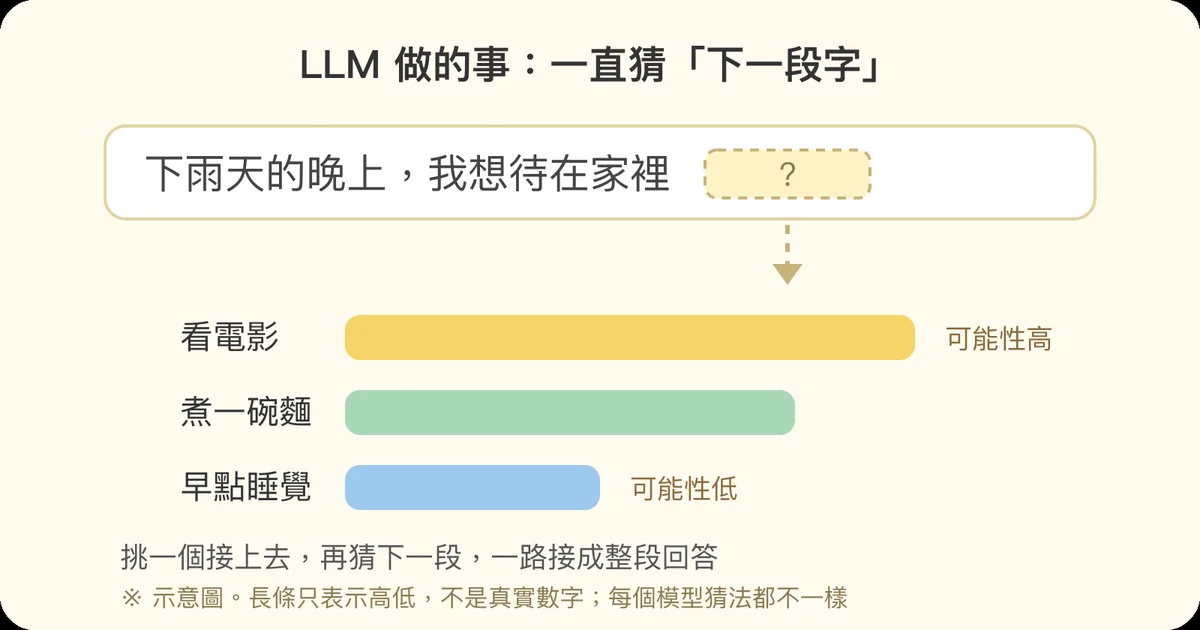
圖:LLM 看前文,替每個可能的下一段字估一個可能性,挑一個接上去,再繼續猜。長條只是示意,不是真實數字。
所以 LLM 不是去資料庫「查答案」,而是依照訓練時學到的文字規律,產生最像樣的下一段。這也是它寫得很流暢、但偶爾會講錯的原因。
Token 是 LLM 處理文字的單位,可能是一個字、一部分的字或一個符號,費用也用 Token 計算。詳見〈Token 是什麼?〉。
「大型」大在哪裡?
「大型」指的是模型裡的參數非常多。參數可以想成模型在訓練時調整出來的大量數字,記錄著文字之間的規律。
- Google 的課程提到,這類模型的參數可達數千億甚至上兆個。
- 研究顯示,參數越多的模型,通常表現越好。
- 代價是訓練要花好幾個月,並消耗大量運算資源與電力。
權重是什麼?8B、70B 的「B」又是什麼?
- 權重(weights)就是參數的主體:模型訓練時學到的那些數字。所以新聞說某家公司「公開權重」,意思是把訓練好的模型本身放出來,讓人下載到自己的電腦或主機上跑。
- B 是 billion(十億),代表參數的數量。名稱裡的 8B 約是 80 億個參數、70B 約是 700 億個。
參數多少,直接影響要用多大的機器來跑:
| 模型大小 | 只載入模型就要的顯示卡記憶體(一般精度) | 適合 |
|---|---|---|
| 8B | 約 16 GB | 一張消費級顯示卡就能跑 |
| 70B | 約 140 GB | 需要多張專業顯示卡 |
| 405B | 約 810 GB | 一台裝 8 張 H100 的主機(約 640 GB)都放不下 |
數字出自 Hugging Face 說明 Meta Llama 3.1 的文章,而且只算「把模型放進記憶體」,實際使用還要再多一些。
- 可以壓小:把每個參數用比較少的位元儲存,叫做量化(Quantization)。同一個 8B 模型壓成 4 位元,大約 4 GB 就放得下,代價是答案可能比較不準。
- 大不一定比較適合:參數多通常比較聰明,但也比較慢、比較貴。Meta 提到,實際使用時大家通常偏好小一點的模型,因為跑起來有效率得多;而且訓練資料多寡也會影響表現,不是只看參數。
- 用 ChatGPT、Claude、Gemini 這類線上服務,不用管這些:模型在服務商的機房跑。只有想把模型放在公司自己的主機上(例如資料不想傳出去),才需要挑大小、算硬體。
LLM 是怎麼訓練出來的?
依 Anthropic 官方名詞表的說明,大致分兩段:
- 預訓練(Pretraining):讓模型讀大量沒有標註的文字,練習「根據前文猜下一個字」。這個階段的模型很會接話,但不太會回答問題或照指示做事。
- 微調(Fine-tuning)與人類回饋(RLHF):再用額外的資料與人類的評分,訓練它好好回答問題、照指示做事、像一個助理。
我們平常用的 AI 助理,都是經過第二段調整後的版本,不是「裸的」語言模型。
LLM 和 ChatGPT、AI Agent 是什麼關係?
| 名詞 | 是什麼 | 比喻 |
|---|---|---|
| LLM | 會讀寫文字的模型本身 | 引擎 |
| AI 助理(ChatGPT、Claude、Gemini) | 把 LLM 包成可以聊天的產品,加上介面、上傳檔案、搜尋、記憶等功能 | 整台車 |
| RAG | 先找出公司文件裡相關的段落,再交給 LLM 回答 | 出發前先給司機看地圖 |
| MCP | 讓 AI 用統一的方式接上外部資料與工具 | 車上的萬用插座 |
| AI Agent | 讓 LLM 自己規劃步驟、呼叫工具、一路把事情做完 | 會自己開到目的地的車 |
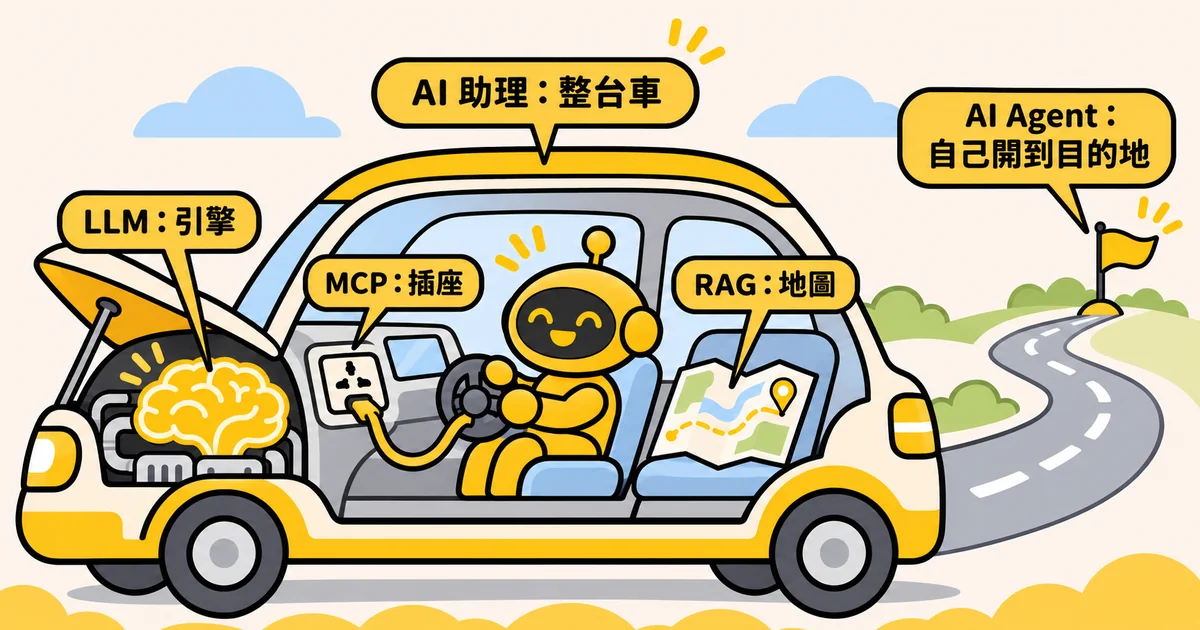
圖:LLM 是引擎,AI 助理是整台車;RAG、MCP、AI Agent 是加在車上的地圖、插座和自動駕駛。
想比較三家 AI 助理的方案與資料隱私,可以看〈ChatGPT、Claude、Gemini 差在哪?〉。
使用 LLM 前要知道的限制
1. 知識有截止日
LLM 的知識來自訓練資料,訓練資料有收集的截止時間。官方模型說明通常會列出「知識截止日」,那之後發生的事,模型本身不知道。
- 要問最新消息、價格、法規,要用有搜尋功能的產品,或自己提供最新資料。
2. 會一本正經地講錯(AI 幻覺)
因為它是「猜最像樣的下一段」,不是查資料,所以可能寫出看起來合理、但其實錯誤或捏造的內容。Google 的課程也明白寫:LLM 會產生幻覺,預測結果常有錯誤。
- 數字、日期、法規、引用來源,一定要對回原始資料。詳見〈AI 幻覺是什麼?〉。
3. 一次能讀的內容有上限
LLM 回答時能參考的內容有上限,叫做 Context Window(上下文視窗)。對話太長、貼太多文件,前面的內容可能被擠掉,或答得不準。詳見〈Token 是什麼?〉的 Context Window 段落。
4. 同一個問題,答案不一定一樣
LLM 每次挑下一段字時帶有一點隨機性,所以同樣的問題問兩次,用詞或內容可能不同。重要的結論不要只問一次就採用。
公司要用 LLM,可以怎麼開始?
- 先從聊天產品開始:讓同事用 AI 助理整理會議紀錄、草擬信件,先熟悉它擅長和不擅長什麼。
- 要讀公司自己的文件:考慮 RAG,讓 AI 根據你的文件回答,而不是憑印象。詳見〈RAG 是什麼?〉。
- 要接進公司系統、讓它幫忙做事:再評估 MCP 與 AI Agent,並先想好權限與資安。詳見〈MCP 是什麼?〉與〈AI Agent 是什麼?〉。
- 不要把機密直接貼進免費的聊天工具:先看清楚該服務怎麼處理你輸入的資料。
常見問題
LLM 是什麼意思?
LLM 是 Large Language Model 的縮寫,中文叫大型語言模型。它是用大量文字訓練出來的 AI 模型,能寫文字、回答問題、整理重點與翻譯,是 ChatGPT、Claude、Gemini 這類 AI 助理背後的核心技術。
LLM 怎麼產生回答?
LLM 根據前面的文字,預測接下來最可能出現的一段字(Token),挑一個接上去後再繼續預測,一段一段接成完整的回答。它不是去資料庫查答案,所以可能寫得流暢但內容有錯。
LLM 和 ChatGPT 有什麼不一樣?
LLM 是模型本身,像引擎;ChatGPT、Claude、Gemini 是把 LLM 包成產品的 AI 助理,另外加上對話介面、上傳檔案、搜尋、記憶等功能。
LLM 和 AI Agent 有什麼不一樣?
LLM 負責讀懂與產生文字;AI Agent 是讓 LLM 自己規劃步驟、呼叫工具,把一件事一路做完的系統。AI Agent 的「大腦」通常就是 LLM。
7B、8B、70B 是什麼意思?
B 是 billion(十億),指模型的參數數量:8B 約 80 億個、70B 約 700 億個。參數越多通常能力越強,但需要的顯示卡記憶體也越多。以一般精度來說,8B 模型光載入就要約 16 GB,70B 要約 140 GB。
權重和參數一樣嗎?
差不多可以當成同一件事。參數是模型訓練時學到的數字,主要就是權重(另外還有少量的偏差值)。「公開權重」的模型,就是把這些訓練好的數字放出來,讓人自己下載來跑。
LLM 的資料是最新的嗎?
不一定。LLM 的知識來自訓練資料,有收集的截止日,之後的事模型本身不知道。要最新資訊,請用有搜尋功能的產品,或自己提供最新資料給它。
法律的 LLM 跟 AI 的 LLM 一樣嗎?
不一樣。法律的 LL.M. 是 Master of Laws,法學碩士學位;AI 的 LLM 是 Large Language Model,大型語言模型。只是縮寫剛好相同。
延伸閱讀
AI 名詞系列:
- Token 是什麼?AI 為什麼用 Token 計費、聊久了為什麼會「忘記」
- AI 幻覺是什麼?AI 為什麼會一本正經地亂講
- RAG 是什麼?讓 AI 讀懂公司文件的「檢索增強生成」
- MCP 是什麼?AI 的「USB-C 接頭」
- AI Agent(AI 代理)是什麼?
- AI 的 Skill 是什麼?把重複的工作流程寫成 AI 的工作手冊
- 開源模型是什麼?7B、70B 怎麼看、要多少顯示卡記憶體
公司想把 LLM 接進自己的系統或流程,可以參考我們的 AI 應用開發服務。
