先講結論:
- RAG(Retrieval-Augmented Generation,檢索增強生成):AI 回答前,先到你指定的資料庫找出相關內容,再根據這些內容回答。
- 好處是:可以用最新、公司內部的資料,回答可以附出處讓人查證,而且不用重新訓練模型。
- 要做得好,關鍵在資料整理與權限控管,不只是接上一個 AI。
這篇會用到「Token」「Context Window」兩個名詞,不熟的話可以先看 Token 是什麼?
RAG 解決什麼問題?
一般的 AI 模型只知道訓練時讀過的資料,而且資料停在某個時間點。直接問它公司內部的事,常見狀況是:
- 不知道答案,卻編一個看起來合理的(這叫 AI 幻覺)。
- 給過時或很籠統的回答。
- 同一個詞在不同情境意思不同,AI 搞混。
RAG 的做法是:不要讓 AI 憑記憶回答,而是先給它正確的資料,再請它回答。
RAG 怎麼運作?四個步驟
依 AWS 的說明,可以拆成四步:
- 準備資料:把公司的文件、資料庫、API 的內容,用「嵌入模型(Embedding)」轉成一串數字(向量),存進向量資料庫。這一步讓電腦能比較「意思接不接近」,而不只是比對關鍵字。
- 檢索:使用者發問時,問題也轉成向量,到資料庫找出意思最接近的幾段內容。
- 增強提示:把找到的內容和原本的問題一起交給 AI,請它根據這些內容回答。
- 持續更新:文件改了,資料庫也要跟著更新,不然 AI 會引用舊資料。
白話比喻:一般 AI 像閉卷考試,只能靠記憶;RAG 像開書考,先翻到相關頁面再作答。
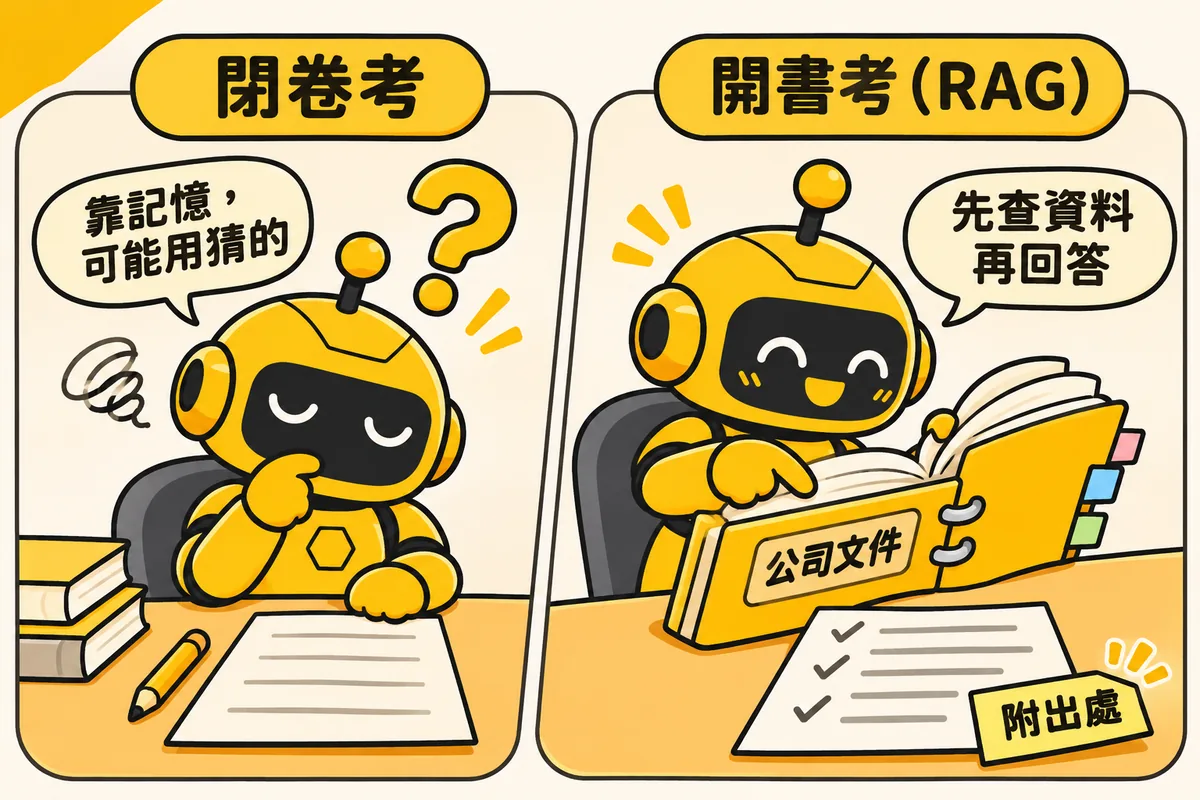
圖:一般 AI 像閉卷考,只能靠記憶,不會時可能用猜的;RAG 像開書考,先翻公司文件找到相關內容,再回答並附出處。
RAG 和「重新訓練模型」差在哪?
| RAG | 重新訓練/微調模型 | |
|---|---|---|
| 做法 | 回答前先查資料 | 把資料「教進」模型 |
| 資料更新 | 更新資料庫即可 | 要重新訓練 |
| 成本 | 相對低 | 高 |
| 能附出處 | 可以 | 不容易 |
| 適合 | 內部文件、FAQ、規章、產品資料 | 要改變模型的語氣、格式或專業能力 |
AWS 的說明也把 RAG 的優點列為:成本較低、能用最新資料、能附出處提高信任、開發者能控制資料來源與存取權限。
公司導入前要先想清楚的事
- 資料先整理:重複、過時、互相矛盾的文件,AI 會照樣引用。先決定哪些是「正本」。
- 權限:不是每個人都能看所有文件。檢索時要依使用者的權限過濾,否則 AI 會把不該看的內容講出來。
- 要附出處:讓使用者能點回原文查證,是降低 AI 幻覺風險最實際的做法。
- 一次給太多也不好:找出來的內容會佔用 AI 的上下文視窗,塞太多反而讓回答變不準。挑「最相關的幾段」比「全部都給」好。
- 更新機制:文件改版後多久同步、誰負責,要先定好。
常見問題
RAG 是什麼意思?
RAG 是 Retrieval-Augmented Generation 的縮寫,中文常譯為「檢索增強生成」。AI 回答前先從指定的資料中找出相關內容,再根據這些內容產生回答。
RAG 和 ChatGPT 上傳檔案一樣嗎?
概念相近,都是讓 AI 參考你提供的資料。差別在 RAG 通常是公司自建的系統:資料量更大、會先建索引、能依使用者權限過濾,並能持續更新。
用了 RAG,AI 就不會亂講了嗎?
不會完全消失,但會明顯降低,因為 AI 是根據查到的資料回答,並能附上出處讓人查證。資料本身錯誤或檢索找錯段落時,答案仍可能出錯。
導入 RAG 需要重新訓練 AI 模型嗎?
不需要。RAG 是在回答前提供資料,模型本身不變;資料更新時只要更新資料庫。
RAG 適合用在哪些地方?
公司內部文件問答、客服 FAQ、產品手冊查詢、法規與規章查詢等「答案在既有文件裡」的情境。
延伸閱讀
想把公司文件做成可以問答的 AI 助理,可以參考我們的 AI 應用開發服務。
