先講結論:
- 7B、70B 的 B 是 billion(十億),指模型的參數數量。7B 約 70 億個、70B 約 700 億個。
- 參數主要就是「權重」:模型訓練時學到的數字。「公開權重」就是把這些數字放出來,讓人下載到自己的電腦或主機上跑。
- 模型越大,需要的顯示卡記憶體越多:一般精度下,8B 模型光載入就要約 16 GB,70B 約 140 GB。
- 量化可以把模型壓小,代價是答案可能比較不準。
- 「公開權重」不等於「開源」,而且每個模型的授權條款不同,商用前要看清楚。
- 用 ChatGPT、Claude、Gemini 這類線上服務,不用管這些;只有想把模型放在自己的主機上,才需要挑大小、算硬體。
先複習:LLM 的「參數」和「權重」
LLM(大型語言模型)是用大量文字訓練出來的 AI 模型。訓練的過程,就是不斷調整模型裡的一大堆數字,讓它越來越會「猜下一段字」。這些數字就叫參數。
依 Google 機器學習名詞表的定義,參數是模型在訓練中學到的「權重和偏差值」,而權重是模型拿來和其他數值相乘的數字。參數裡絕大部分是權重,所以一般講「權重」,指的就是訓練好的模型本身。
還不熟 LLM 的話,可以先看〈LLM 是什麼?大型語言模型白話說明〉。
7B、8B、70B 是什麼意思?
模型名稱後面的數字加 B,代表參數的數量,B 是 billion(十億):
| 寫法 | 參數數量(約) |
|---|---|
| 2B | 20 億 |
| 7B/8B | 70 億/80 億 |
| 70B | 700 億 |
| 405B | 4,050 億 |
Google 的 web.dev 文件也這樣說明:模型標示的大小指的是參數數量,例如 Gemma 2B 代表約 20 億個參數,「約」是因為不會剛好是整數。
同一個系列裡,越大通常越聰明,能處理比較複雜的問題;越小則越快、越省資源,但同樣的工作可能要把問題寫得更清楚。
要多少顯示卡記憶體?
跑模型時,參數要先放進記憶體。參數越多,要的記憶體越多。Hugging Face 介紹 Meta Llama 3.1 時,列出三種尺寸「只載入模型」需要的顯示卡記憶體:
| 模型大小 | 一般精度(16 位元) | 8 位元 | 4 位元 |
|---|---|---|---|
| 8B | 約 16 GB | 約 8 GB | 約 4 GB |
| 70B | 約 140 GB | 約 70 GB | 約 35 GB |
| 405B | 約 810 GB | 約 405 GB | 約 203 GB |
可以看出一個簡單的規律:一般精度下,每 10 億個參數約需 2 GB。
幾個要注意的地方:
- 這只是「把模型放進去」的量,實際使用時還要再多一些(例如對話內容越長,要的記憶體越多)。
- Hugging Face 說 8B 模型約 16 GB,很多消費級顯示卡放得下;405B 連一台裝 8 張 H100 的主機(約 640 GB)都放不下,要多台主機或降低精度。
- 不同模型的實際需求不完全一樣,下載前請看該模型自己的說明。
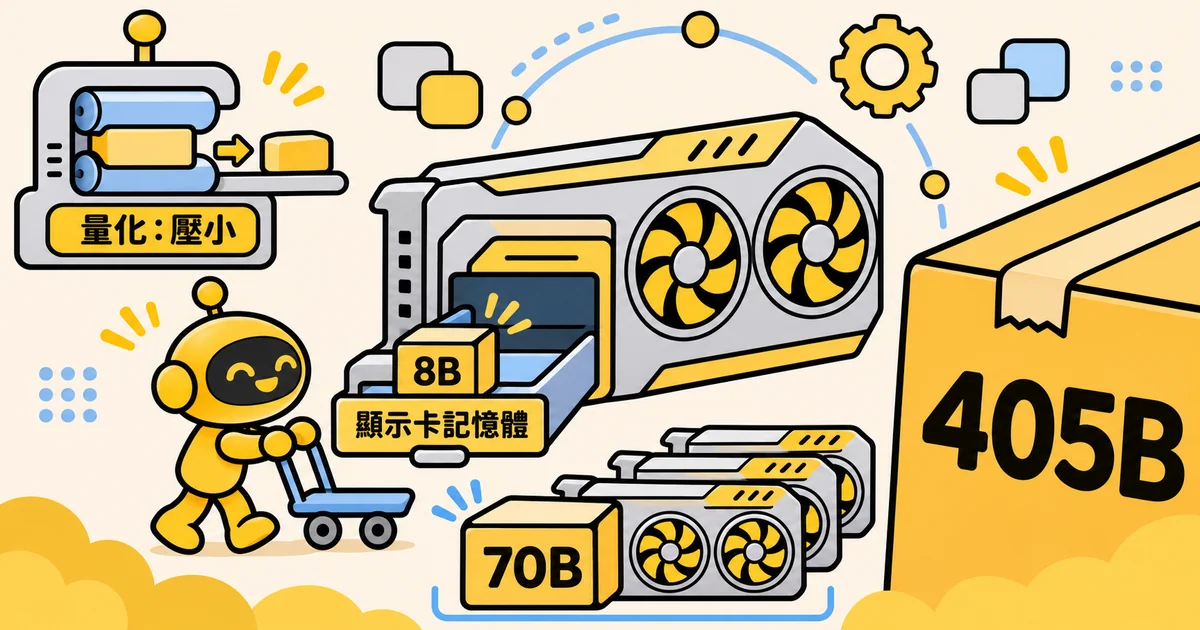
圖:模型越大,需要的顯示卡記憶體越多;量化可以把模型壓小。
量化是什麼?把模型壓小的方法
量化(Quantization) 是把每個參數用比較少的位元來存。例如原本用 16 位元存一個數字,改成 8 位元或 4 位元。上面那張表的 8 位元、4 位元,就是量化後的大小。
Google 名詞表的說明是:量化可以減少運算量、記憶體和耗電,但有時會降低模型的準確度。
所以常見的取捨是:
- 機器不夠大 → 用量化版本,先跑得起來。
- 答案品質很重要 → 用比較高的精度,或換大一點的機器。
參數越多一定越好嗎?
不一定。幾個官方說法可以參考:
- web.dev:針對自己用途微調過的小模型,表現可能比通用的大模型更好。
- Meta(Llama 3 發表文):實際使用時,大家通常偏好小一點的模型,因為跑起來有效率得多;他們也發現,用遠多於傳統建議的資料去訓練 8B 模型,表現還會持續進步。也就是說,訓練資料多寡也很重要,不是只看參數。
挑模型時比較實際的順序是:先確定要做什麼事 → 用幾個不同大小的模型實際測試 → 選「夠用」的最小那個。
「開源模型」和「開放權重」一樣嗎?
新聞常把可以下載的模型都叫「開源模型」,但嚴格來說不一樣:
- 開放權重(open weights):公開訓練好的權重,讓人下載使用。Hugging Face 介紹 Llama 3.1 時,用的就是 open-weight models 這個說法。
- 開源 AI(Open Source AI):依推動開源授權的 Open Source Initiative(OSI)定義,除了參數,還要提供足夠詳細的訓練資料說明和訓練與執行用的完整程式碼,並允許任何人為任何目的使用、研究、修改、分享。只公開權重,不符合這個定義。
和「開源」相對的說法是閉源或不公開權重的模型:ChatGPT、Claude、Gemini 這類服務背後的主要模型,只能透過服務商的網站或 API 使用,不能下載。
授權條款要看什麼?
能下載,不代表可以隨便用。每個模型都有自己的授權條款,商用前一定要看。以 Meta 的 Llama 3.1 社群授權為例:
- 產品或服務的每月活躍用戶超過 7 億,要另外向 Meta 申請授權。
- 散布 Llama 或含有 Llama 的產品,要明顯標示「Built with Llama」。
- 用 Llama 或它的輸出去訓練、微調另一個公開的模型,模型名稱開頭要加上「Llama」。
其他模型的條款可能更寬鬆,也可能更嚴格。條款會更新,請以下載當下的官方授權文件為準。
公司什麼時候需要自己跑模型?
大多數情況下,用線上服務就夠了,不用自己準備機器。會考慮自己跑模型,通常是因為:
- 資料不能傳出去:例如客戶個資、內部機密,規定不能送到外部服務。
- 要在沒有網路的環境使用:例如工廠、內網系統。
- 用量很大、內容很固定:同一件事每天要做非常多次,自己跑可能比較划算(要實際算過硬體、電費和維護人力)。
- 要針對自己的資料微調:讓模型更懂公司的用語和流程。
自己跑模型要多負責的事:準備與維護硬體、更新模型、控制誰能用、留下使用紀錄。這些在線上服務是服務商在做。
如果只是想讓 AI 讀懂公司文件,不一定要自己跑模型,可以先看〈RAG 是什麼?〉。
常見問題
7B 是什麼意思?
B 是 billion(十億),7B 指模型約有 70 億個參數。參數是模型訓練時學到的數字,數量越多通常能力越強,但需要的記憶體也越多。
7B 模型需要多少顯示卡記憶體?
以一般精度(16 位元)估算,每 10 億個參數約需 2 GB,所以 7B 到 8B 的模型光載入就要約 14 到 16 GB;量化成 4 位元大約 4 GB 左右。實際使用還要再多一些,請以該模型的說明為準。
權重和參數有什麼不一樣?
參數是模型訓練時學到的所有數字,主要是權重,另外還有少量的偏差值。一般講「公開權重」,就是把訓練好的模型本身放出來。
開源模型和閉源模型差在哪?
開源或開放權重的模型可以下載到自己的電腦或主機上跑;閉源模型只能透過服務商的網站或 API 使用。嚴格來說,「開放權重」不等於「開源」:依 OSI 的定義,開源 AI 還要公開訓練資料說明和完整程式碼。
量化會讓模型變笨嗎?
有可能。量化是用比較少的位元存參數,可以省下記憶體與運算,但有時會降低準確度。要不要量化,要用自己的實際工作測過再決定。
開源模型可以免費商用嗎?
要看每個模型的授權條款。以 Llama 3.1 為例,可以商用,但每月活躍用戶超過 7 億要另外申請授權,散布時也要標示「Built with Llama」。商用前請看下載當下的官方授權文件。
延伸閱讀
AI 名詞系列:
- LLM 是什麼?大型語言模型白話說明
- Token 是什麼?AI 為什麼用 Token 計費、聊久了為什麼會「忘記」
- RAG 是什麼?讓 AI 讀懂公司文件的「檢索增強生成」
- AI Agent(AI 代理)是什麼?
公司想把 AI 放在自己的主機上,或接進現有系統,可以參考我們的 AI 應用開發服務。
